Alle reden über KI. Doch es gibt ein grundlegendes Problem, das die meisten Diskussionen stillschweigend übergehen: KI kann schlechte Cleanroom-Datenqualität nicht beheben. Sie verstärkt sie.
In Cleanrooms erzeugen wir schon heute jeden Tag riesige Datenmengen: Temperatur, relative Luftfeuchtigkeit, Druckkaskaden, Volumenströme, Energieverbrauch, Türbewegungen, HLK-Verhalten, Filterleistung, Alarme, Ventilatorstatus, Ventilstellungen und Sensorwerte. Die Daten sind nicht das Problem. Die eigentliche Frage wird selten laut genug gestellt: Können wir diesen Daten genug vertrauen, um danach zu handeln?
Warum die Cleanroom-Datenqualität das eigentliche Hindernis für KI in regulierten Umgebungen ist
Messung ist nicht gleichbedeutend mit Verständnis. Das Erfassen von Daten ist nicht gleichbedeutend mit der Entwicklung einer zuverlässigen Systemintelligenz. Diese Unterscheidung ist von enormer Bedeutung, wenn künstliche Intelligenz ins Spiel kommt.
Überlegen Sie, was passiert, wenn die Datenqualität auf der Eingabeebene beeinträchtigt wird. Jeder Fehler führt direkt zu einem KI-Modell, das auf dieser Grundlage erstellt wurde.
Ein driftendes Sensoraggregat bewirkt, dass ein Modell einen Trend erkennt, der nicht existiert, was zu falschen Alarmen oder, schlimmer noch, fehlenden tatsächlichen Abweichungen führt. Das Fehlen von Kontext führt dazu, dass normales Prozessverhalten als Anomalie interpretiert wird und das Vertrauen der Betreiber in das gesamte System beeinträchtigt wird. Unvalidierte Datenströme bedeuten, dass man vorausschauende Modelle auf Sand baut; die Grundlage ändert sich, und damit auch jede daraus abgeleitete Schlussfolgerung. Lücken oder falsche Zeitstempel unterbrechen Zeitreihenmodelle, die von der Datenkontinuität abhängig sind, um frühe Abnahmeerscheinungen zu erkennen.
Das Ergebnis ist nicht nur ungenaue KI, sondern ein System, das selbstbewusst falsche Antworten liefert. In einer regulierten Cleanroom-Umgebung ist das kein Softwareproblem, sondern ein Compliance- und Produktionsrisiko. Cleanroom-Intelligenz beginnt vor der KI: mit Datenqualität, validierter Sensorinfrastruktur und betrieblichem Kontext, der den Daten Bedeutung gibt.
Was vertrauenswürdige Cleanroom-Daten wirklich erfordern
Vertrauenswürdige Cleanroom-Daten sind nicht einfach gesammelte Daten. Es sind Daten, die validiert, in Kontext gesetzt und über lange Zeit unter realen Betriebsbedingungen gesammelt wurden. Das ist weit schwieriger, als Monitoringgeräte zu installieren.
Validierung auf Sensor- und Systemebene
Jeder Datenpunkt, der in ein Cleanroom-Intelligenzsystem einfließt, muss aus einer kalibrierten, validierten Quelle stammen. Sensordrift muss laufend erkannt und korrigiert werden. Alarmgrenzen müssen sinnvoll sein, nicht willkürliche Standardwerte aus einem früheren Projekt. Das erfordert einen konsequenten, fortlaufenden Ansatz für Messqualität, der weit über jährliche Kalibrierzyklen hinausgeht.
Betriebsrahmenbedingungen
Rohdaten ohne Kontext sind Lärm. Ist die Druckdifferenzmessung ein Abweichungswert oder ist eine Tür für eine Materialübertragung offen gehalten? Ist der Temperaturanstieg ein Systemfehler oder ein geplanter Autoklavzyklus? Ohne operativen Kontext, der in die Datenstruktur eingebettet ist, kann selbst das raffinierteste KI-Modell keine Routineverhalten zuverlässig von echten Anomalien unterscheiden.
Historische Tiefe
Mustererkennung – die Kernfähigkeit, die KI im Cleanroom-Monitoring wirklich nützlich macht – erfordert historische Tiefe. Nicht Wochen, sondern Jahre. Man braucht genügend Daten aus genügend Betriebszuständen, Wartungsereignissen, saisonalen Schwankungen und Prozessänderungen, um einem Modell beizubringen, wie „normal“ über das gesamte Verhaltensspektrum eines Cleanrooms tatsächlich aussieht.
Wie ABN Cleanroom Technology dieses Fundament seit 2015 aufbaut
Seit 2015 überwacht ABN Cleanroom Technology die Leistung von Cleanroom-Systemen kontinuierlich mit CleanConnect, entwickelt von der Schwesterfirma Smartlog. Das sind fast zehn Jahre echte Zeitreihendaten aus Cleanrooms im Betrieb in ganz Europa, erfasst unter realen Produktionsbedingungen statt in kontrollierten Laborumgebungen. ABN gehörte zu den Ersten in der EU, die dies in diesem Umfang taten.
Das ist keine rückblickende Berichterstattung. Diese historischen Daten werden zur strategischen Grundlage für die nächste Generation der Cleanroom-Intelligenz. Im Configure-to-Order-Plus-Ansatz (CTO+) von ABN sind Daten kein nachträglicher Gedanke und kein bloßer Compliance-Nachweis. Sie fließen aktiv ein, um künftige Cleanrooms schon vor Baubeginn intelligenter, zuverlässiger und planbarer zu machen. Betriebserkenntnisse fließen direkt in die ADAPTUS-Plattform zurück, die vorkonstruierte, validierte Systemarchitektur hinter jeder ABN-Cleanroom-Konfiguration.
Was KI in Cleanrooms tatsächlich leisten kann, wenn die Daten stimmen
Mit der richtigen Datenqualität und genügend historischer Tiefe geht KI weit über Dashboards und Ausnahmeberichte hinaus. Möglich werden genau die Fähigkeiten, die für Zuverlässigkeit und Compliance im Cleanroom am meisten zählen.
Die Anomalieerkennung vor einer Eskalation bedeutet, Abweichungen bereits bei der ersten Anzeichen ihrer Entstehung zu erkennen – bevor sie zu Ausfallereignissen werden, die CAPA-Prozesse auslösen. Die frühzeitige Erkennung von Abweichungen bedeutet, Leistungsabfall in Filtern, Verlust der Lüftereffizienz oder Sensordrift bereits Wochen vor dessen Entwicklung zu erkennen, bevor er zu einem Instandhaltungsproblem wird. Die vorausschauende Instandhaltung bedeutet, Interventionen basierend auf dem tatsächlichen Systemverhalten zu planen, anstatt auf festen Intervallannahmen zu setzen, wodurch sowohl unvorhergesehene Ausfallzeiten als auch unnötige Instandhaltungskosten reduziert werden. Die Erkennung von Systemverhalten basiert auf dem Erkennen von Systemverhalten, das dem menschlichen Auge über Tausende von Stunden an Betriebszahlen verborgen bleibt.
Die Optimierung der Verfügbarkeit bedeutet die Kombination von redundanter Architektur mit vorausschauenden Daten, um Verfügbarkeitsniveaus zu erreichen und zu halten, die reine reaktive Instandhaltung nicht erreichen kann.
Diese Ergebnisse sind nicht theoretisch. Sie werden realisierbar, wenn die Dateninfrastruktur dahinter validiert, kontextualisiert und ausreichend detailliert ist, um eine zuverlässige Modellbildung zu ermöglichen.
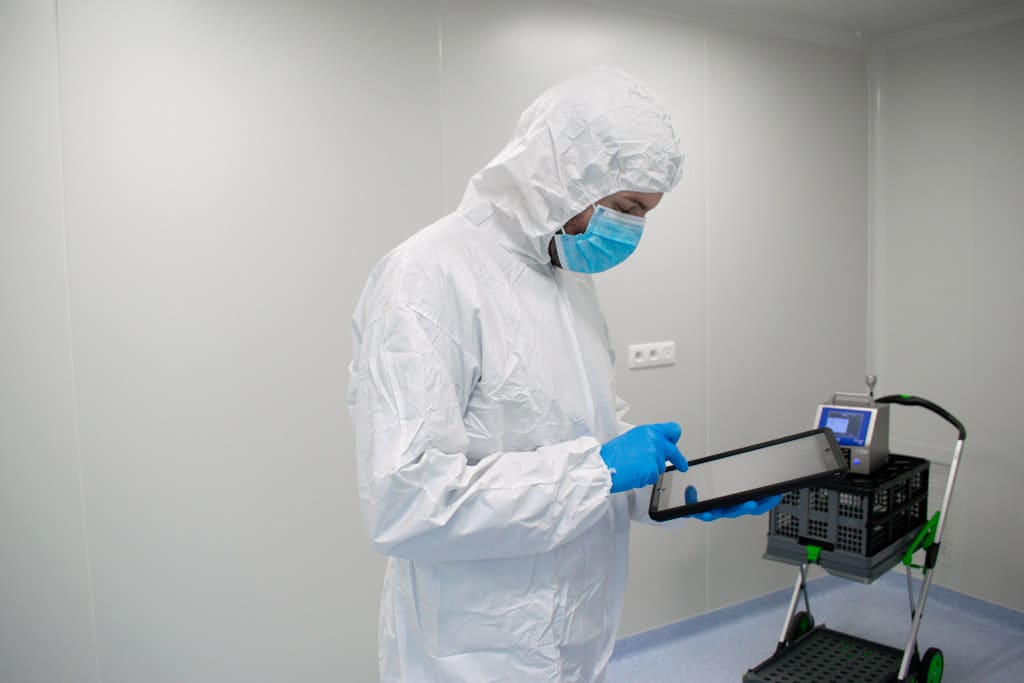
Wie Configure-to-Order Plus Datenqualität vom ersten Tag an in das Cleanroom-Design integriert
Die meisten Cleanroom-Projekte behandeln Daten als Betriebsschicht, die nach dem Bau hinzugefügt wird. Monitoringsysteme werden installiert, Sensoren angeschlossen, Dashboards eingerichtet. Die Datenerfassung beginnt erst, wenn der Cleanroom bereits läuft.
Das CTO+-Framework von ABN funktioniert anders. Datenqualität und Leistungsintelligenz sind auf Plattformebene verankert, nicht nach der Lieferung nachgerüstet. Jeder über ADAPTUS konfigurierte Cleanroom beginnt mit validierten, vorkonstruierten Bausteinen mit bekannten Leistungsmerkmalen, einschließlich der Monitoringarchitektur, die vom ersten Tag an vertrauenswürdige Betriebsdaten liefert.
Das betrifft alle vier kritischen Werte, die CTO+ absichert. Kontinuierliches Monitoring unterstützt die redundante Architektur, die eine Verfügbarkeit von bis zu 99,995 % pro Jahr ermöglicht. Bedarfsgesteuerte, datengestützte Luftstromregelung senkt den Energieverbrauch, ohne die Cleanroom-Klassifizierung zu gefährden. Vorausschauende Wartung reduziert die Kosten ungeplanter Ausfälle und senkt die Betriebskosten über den gesamten Lebenszyklus.
Das unterscheidet CTO+ von üblichen Configure-to-Order-Ansätzen. Konfiguration betrifft nicht nur physische Bausteine, sondern auch die Verankerung der Datenqualität in der Systemarchitektur selbst, sodass Intelligenz vom ersten Betriebstag an möglich ist.
Die Zukunft des Cleanroom-Monitorings sind nicht intelligentere Dashboards. Es sind intelligentere Systeme.
Die Cleanroom-Branche steht an einem Wendepunkt. Den nächsten Wettbewerbsvorteil gewinnt nicht das Unternehmen, das die meisten Sensoren installiert oder das ausgefeilteste KI-Modell einsetzt, sondern das Unternehmen, das jahrelang die Datenbasis aufgebaut hat, die KI in einem regulierten Umfeld vertrauenswürdig macht.
Die Zukunft sind nicht Cleanrooms, die geplant, gebaut und validiert werden, sondern Cleanroom-Systeme, die aus ihrem eigenen Verhalten lernen. Systeme, die mit der Zeit intelligenter werden. Systeme, die Betriebsdaten in Designwissen verwandeln, das in die nächste Generation von Konfigurationen einfließt, sodass Zuverlässigkeit ein Ergebnis gesammelten Lernens wird und nicht allein eine Frage ingenieurtechnischen Urteils.
Konfiguriert durch Engineering. Verbessert durch Daten. Gestärkt durch KI. Dort wird Cleanroom-Zuverlässigkeit gewonnen. Und sie beginnt nicht mit dem KI-Modell, sondern mit der Entscheidung, die Jahre zuvor getroffen wurde: Cleanroom-Datenqualität als nicht verhandelbares Fundament zu behandeln statt als Nebensache.
Daten sind im Cleanroom-Betrieb kein Nebenthema. Daten sind das Fundament – aber nur, wenn die Qualität stimmt.